Perfilado y medición de calidad de datos con evidencia. Cada resultado declara su alcance y lo que no pudo medir.
🔎 Qué hace y para quién
lupa examina una tabla o una base de datos antes de confiar en ella. Encuentra lo que un summary() no ve:
- faltantes disfrazados de
"S/D"o de-99; - el mismo dato escrito de varias formas;
- fechas en formatos mezclados;
- filas y columnas repetidas;
- estructura que nadie declaró.
Dice en qué filas está la mayoría de los problemas y qué controles no pudo hacer. Después ayuda a convertir lo confirmado en mediciones, a evaluarlas, a limpiar una copia con un plan editable y a comparar entregas. Es para quien analiza, produce o publica datos tabulares y necesita saber qué tan confiables son antes de usarlos.
Lo que lo distingue:
- No resume la calidad en un puntaje. Cada contradicción trae su tipo, su severidad y su evidencia.
- Cada cifra viaja con su alcance: las filas que usó y si hubo muestra.
- Lo que no se pudo medir queda declarado, con su motivo. Nunca cuenta como cero.
- El perfilado no modifica la entrada.
Instalación
La versión publicada se instala desde CRAN:
install.packages("lupa")la versión de desarrollo, ya construida, desde r-universe:
install.packages(
  "lupa",
  repos = c("https://sebollin.r-universe.dev", "https://cloud.r-project.org")
)
o la misma versión de desarrollo, desde GitHub:
# install.packages("pak")
pak::pak("sebollin/lupa")
Depende sólo de cli y data.table. Los sugeridos habilitan capacidades acotadas:
-
DBIcon un controlador (RSQLite,duckdb,RPostgresuodbc) para perfilar dentro de una base; -
stringdistpara comparar texto de forma aproximada; -
sfpara geometrías.
La API, la ayuda y las guías están en castellano; los nombres públicos son parte del contrato. El sitio tiene además una versión en inglés de 4 guías, en Guides in English.
⏱ En 30 s
datos_operativos viene con el paquete: 13 filas y 10 columnas con defectos sembrados. Se perfila con una llamada y se empieza por los hallazgos de severidad error:
library(lupa)
perfil <- perfilar(datos_operativos)
h <- hallazgos(perfil)
errores_primero <- order(h$severidad, decreasing = TRUE)
print(head(h[errores_primero, c("columna", "tipo_hallazgo", "severidad")], 8),
      row.names = FALSE)
#>         columna           tipo_hallazgo  severidad
#>  codigo_usuario   faltantes_disfrazados      error
#>    fecha_evento   faltantes_disfrazados      error
#>    fecha_evento   formatos_fecha_mixtos      error
#>           canal   faltantes_disfrazados      error
#>            <NA>        filas_duplicadas      error
#>  codigo_usuario       alta_cardinalidad sospechoso
#>    fecha_evento       alta_cardinalidad sospechoso
#>    fecha_evento tipo_declarado_distinto sospechoso
Una columna en <NA> es un hallazgo de la tabla entera, como las filas duplicadas.
Lo que no se pudo medir no desaparece. En esta tabla quedaron 9 diagnósticos sin evaluar, contando cada uno en cada columna donde no pudo correr: la búsqueda de valores atípicos, por ejemplo, necesita más valores de los que hay. cobertura(perfil) dice cuáles, en qué columna, por qué y cómo resolverlo:
as.data.frame(table(diagnostico = cobertura(perfil)$diagnostico), responseName = "columnas")
#>              diagnostico columnas
#> 1               outliers        4
#> 2            patron_raro        1
#> 3 proximidad_vocabulario        3
#> 4   resumen_cuantitativo        1
🗄️ Tablas y bases de datos
perfilar() perfila un data.frame en memoria. perfilar_dbi() perfila una tabla dentro de la base: los agregados corren como SQL en el motor, y a R llegan sólo las filas que entran en los topes. La misma superficie se mide contra 6 motores reales:
| Motor | Versión probada | Controlador de R |
|---|---|---|
| DuckDB | 1.5 | duckdb |
| MariaDB | 11 | RMariaDB |
| MySQL | 8 | RMySQL |
| PostgreSQL | 9.3 y 16 | RPostgres |
| SQL Server | 2022 | odbc |
| SQLite | — | RSQLite |
PostgreSQL 16 y MariaDB se miden en cada push (CI de motores), y SQLite y DuckDB en la suite de pruebas de cada plataforma de la CI; MySQL, SQL Server y PostgreSQL 9.3, contra contenedores locales antes de cada versión. Oracle debería funcionar pero no está medido, y BigQuery no está documentado. requisitos_motor() dice qué necesita cada motor. Las versiones, los controladores y la fecha de cada corrida están en Motores y escala.
Lo que summary() no muestra
summary() describe las columnas una por una. lupa compara representaciones, cruza columnas y filas, y devuelve los hallazgos como una tabla: tipo, severidad, evidencia, conteos, una sugerencia y la trazabilidad hasta las filas. Un tipo de hallazgo que no aparece es un diagnóstico que corrió y no encontró nada; lo que no corrió está en cobertura().
Entre las salidas de esa corrida aparecen:
| Qué deja visible | tipo_hallazgo |
Evidencia (recorte) |
|---|---|---|
| Faltantes escondidos detrás de códigos | faltantes_disfrazados |
<blanco> (1); S/D (1) |
| Fechas en formatos mezclados | formatos_fecha_mixtos |
%Y-%m-%d (4); %d/%m/%Y (4); ... |
| Espacios sobrantes | espacios_sobrantes |
1 valor; ejemplos: "web " |
| Mayúsculas inconsistentes | mayusculas_inconsistentes |
"web"; "Web" |
| El tipo declarado y el inferido no coinciden | tipo_declarado_distinto |
Declarado: texto; inferido: fecha (0.846 compatible); ... |
| Una columna constante | constante |
Valor: principal; frecuencia: 13 |
| Filas duplicadas exactas | filas_duplicadas |
2 filas en grupos duplicados (1 excedente) |
| Columnas repetidas | columnas_duplicadas |
id_registro = id_copia; comparadas sobre 13 filas |
El vocabulario completo, con lo que significa cada tipo de hallazgo, está en el artículo Alcance y cobertura.
Cómo se lee un perfil
severidad es un factor ordenado: ok < sospechoso < error.
-
okregistra una condición informativa, no una aprobación: que una columna parezca un identificador esok. -
sospechosopide mirar con contexto:alta_cardinalidadencodigo_usuariosugiere revisar si es texto libre, un identificador o una categoría mal normalizada. -
errordice que un control cruzó su criterio declarado. Es el único nivel que conviene usar como barrera automática, y sólo después de aceptar ese criterio.
Con clave, cada hallazgo trae los valores que identifican sus filas, y el caso se busca en el sistema de origen sin abrir la tabla:
con_clave <- perfilar(datos_operativos, clave = "id_evento")
#> Warning: La clave declarada no es única: entre 13 filas con la clave completa, 1 repite su valor
#> (2 filas participan en colisiones). La clave cumple la ausencia de nulos: no tiene
#> valores ausentes.
h <- hallazgos(con_clave)
fila <- which(h$tipo_hallazgo == "faltantes_disfrazados" &
                h$columna == "fecha_evento")
claves <- h$trazabilidad[[fila]]$claves
claves
#>   id_evento
#> 1    EVT011
datos_operativos[datos_operativos$id_evento %in% claves$id_evento,
                 c("id_evento", "fecha_evento")]
#>    id_evento fecha_evento
#> 13    EVT011         NULL
El aviso es parte de la respuesta: datos_operativos tiene una fila duplicada, así que ninguna clave puede ser única, y el perfil lo registra como hallazgo clave_no_unica de severidad error.
Lo que no se pudo medir queda registrado, nunca contado como cero. Por eso una automatización que busca error tiene que leer también cobertura(): cero errores con diagnósticos sin evaluar no es un perfil limpio.
Los conteos (filas, faltantes, valores distintos, duplicados exactos y resúmenes) usan todas las filas; los patrones, los tipos y los formatos de fecha se infieren sobre una muestra sistemática de hasta 100.000 filas (muestra). La guía Leer un perfil explica cada columna de los hallazgos, las claves, las discordancias entre columnas y el glosario.
Dónde se ubica
Para resumir y graficar columnas están skimr y DataExplorer; para diagnosticar una tabla y redactar su informe, dlookr y dataReporter; para evaluar reglas que alguien ya escribió, validate, pointblank, assertr y dataquieR. lupa trabaja en el tramo anterior a la regla y en el siguiente: encuentra lo que todavía ninguna regla nombra, propone qué medir sin umbrales de fábrica y, cuando la regla se confirma, la mide con su alcance, limpia una copia y compara entregas. Se usa junto a esos paquetes, no en su lugar.
Mapa de funciones
La referencia documenta cada función.
Perfilar una base: qué trae a R
perfilar_dbi() devuelve dos bloques: resumen_tabla, con los agregados que el motor calcula por SQL, y perfil_muestra, el perfil por fila de lo que se lee a R. Por omisión los agregados usan toda la tabla y el perfil por fila intenta traer todas las filas que entran en los topes: no es una muestra barata.
con <- DBI::dbConnect(RSQLite::SQLite(), ":memory:")
DBI::dbWriteTable(con, "eventos", datos_operativos)
en_la_base <- perfilar_dbi(con, "eventos")
names(en_la_base)
#> [1] "resumen_tabla" "perfil_muestra"| Opción | Agregados SQL sobre | ¿Trae filas a R? |
|---|---|---|
Por omisión: universo = "tabla_completa", muestra = Inf
|
toda la tabla | Sí: todas las que entran en los topes de celdas y de bytes |
muestra = n |
toda la tabla | Sí, hasta n: acota la lectura, no los agregados |
universo = "muestra_motor", muestra_motor = n
|
hasta n filas muestreadas por el motor |
Sí, las que se materializan después de los topes |
bloque_muestra = "solo_agregados" |
lo que diga universo
|
No: sólo agregados, sin hallazgos por fila |
Sin orden_muestra, la lectura de muestra = n son las primeras filas que entrega el motor, en un orden que SQL no garantiza; con orden_muestra se puede rehacer. Lo leído a R se describe en perfil_muestra$meta$origen_dbi$muestreo; resumen_tabla$meta$muestreo existe sólo con universo = "muestra_motor". No hay lectura instantánea: resumen_tabla$meta$snapshot es FALSE, porque cada agregado se mide en su propia consulta y la tabla puede cambiar entre una y otra.
Los motores probados son DuckDB, MariaDB, MySQL, PostgreSQL, SQL Server y SQLite. El recorrido paso a paso está en Perfilar una base.
⚠️ Límites que conviene conocer antes de una corrida grande
-
Topes de muestra. Lo que se trae o se muestrea en R se corta en 1.000.000 celdas (
max_celdas_muestra) y 512 MiB (max_bytes_muestra), y el recorte queda encobertura()con el tope que mandó (Motores y escala). Enmuestra_motor, el spool usa un tamaño máximo de fila conservador antes de cadadbFetch(n). El texto largo se pide como largo y resumen MD5, así que su contenido no puede hacer que una lectura pase esa cota; los tipos sin cota conocida se sondean de a una fila. Registra las filas pedidas y efectivas, el tamaño medido y la fracción real antes de devolver el perfil. -
Política de costo. En
perfilar_dbi(),politica_costo = "todas"(por omisión) mide moda y mediana en todas las columnas;"por_cardinalidad"omite la moda donde la proporción de distintos llega aumbral_cardinalidad(0,5), yplan_perfilado_dbi()muestra las consultas antes de correrlas (Motores y escala). -
Duplicados aproximados. Están apagados por omisión.
detectar_duplicados_aproximados()compara de forma exacta hasta 50.000.000 pares (max_pares). Con la estrategia por omisión ("auto"), sin muestra y con ese tope, más de 10.000 filas la llevan a MinHash/LSH, que puede perder pares y lo declara (candidatos, bandas y garantía de colisión); con unmax_paresmenor o una muestra se queda en la comparación exacta o muestreada, yestrategia = "lsh"lo fuerza.estimar_costo()lo anticipa (Escala y duplicados aproximados). -
Tablas anchas. Desde 100.000 celdas, una sesión interactiva recibe un aviso de cuánto puede tardar
perfilar(); la estimación usa una referencia del código (5.000 celdas por segundo), fijada por debajo de la medición más lenta, con columnas numéricas y categóricas y con columnas iguales de códigos de texto; las mediciones fechadas están en Evidencia y rendimiento. -
Millones de filas en memoria.
perfilar()yanalizar()tardan minutos, no segundos: conviene perfilar una muestra o usarperfilar_dbi(). Las cifras medidas, con su fecha, están en Evidencia y rendimiento.
📄 Un informe en un archivo
analizar() reúne en un objeto el perfil, las distribuciones, las asociaciones, el análisis temporal, una propuesta de modelo de calidad con su tablero y un plan de limpieza; reportar() lo escribe en un HTML autocontenido para compartir.
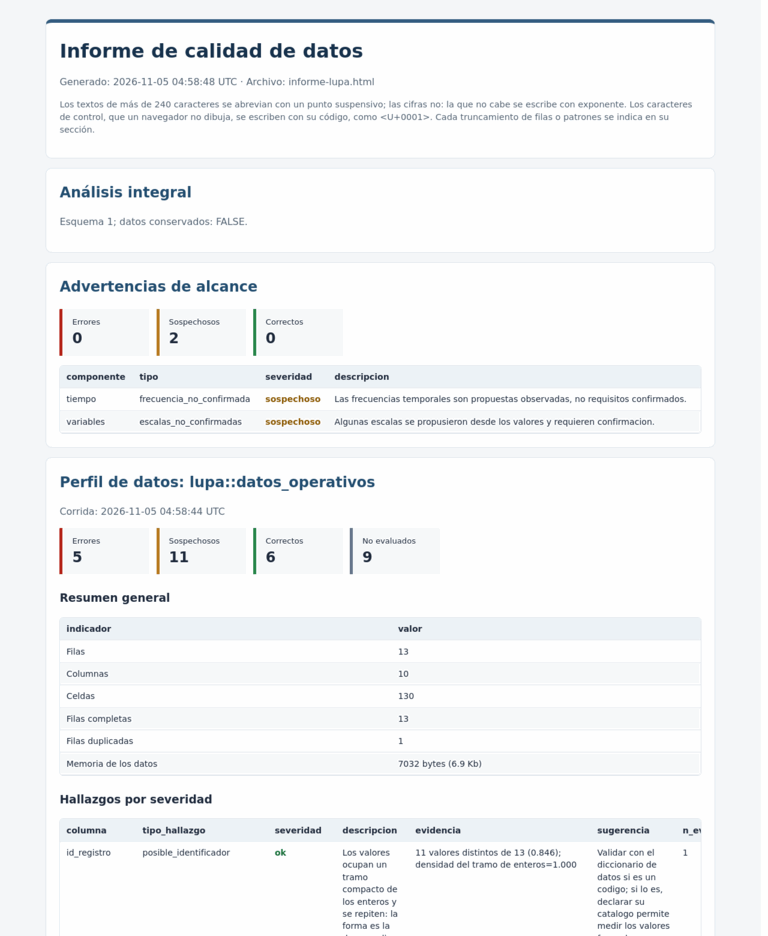
La propuesta es una sugerencia: los dominios y los patrones aprendidos de la misma entrega se proponen inactivos y no se miden hasta que alguien los confirma. guardar_analisis() y leer_analisis() conservan el recorrido entero. La guía es Explorar columnas con analizar().
Qué no hace
lupa no convierte el nombre de un marco de calidad en una medición. Un marco es una taxonomía: un factor se mide cuando los datos aportan evidencia o cuando se declaran el requisito y la métrica que lo mide. Esta es la cobertura de los marcos incluidos:
| Marco | Factores | Alcanzables declarando | Fuera de alcance | Los mide perfilar() solo |
|---|---|---|---|---|
| AGESIC | 17 | 12 | 5 | 2 |
| CEPAL | 19 | 6 | 13 | 0 |
| ISO/IEC 25012 | 15 | 15 | 0 | 0 |
Los 13 principios de CEPAL fuera de alcance hablan del sistema estadístico y de su proceso institucional, no de los valores de una tabla. ISO/IEC 25012 se cubre entero cuando se declaran sus requisitos y métricas. cobertura_analisis() informa qué factores quedaron medidos; que no haya hallazgos no afirma que los datos sean buenos.
Tampoco certifica un conjunto de datos ni inventa un puntaje global: indice_calidad() calcula un índice sólo con los pesos que declara el proyecto. Y no modifica la entrada: ninguna función de análisis altera la tabla que recibe (ni sus valores, ni sus tipos, ni sus nombres, ni sus atributos), tampoco un data.table. La limpieza devuelve una copia y deja el original intacto.
🧭 El camino de aprendizaje
Las guías se leen en este orden, y las 12 están en el sitio. Las guías 1 a 6 viajan además con el paquete (vignette("lupa") abre la primera); de la 7 a la 12 están sólo en el sitio.
-
Empezar en diez minutos: perfilar una tabla, empezar por los errores, ir de un hallazgo a sus filas con
clave, leer la cobertura, guardar un informe y limpiar una columna en una copia. - Leer un perfil: las severidades, qué trae cada hallazgo, los accesores, las claves, las contradicciones entre columnas y el glosario.
-
Explorar columnas con
analizar(): qué armaanalizar()en una llamada, cómo se leen patrones, tipos, fechas, distribuciones, asociaciones y tiempo, y cómo se guarda y se informa. - Estructura no declarada: claves candidatas, relaciones entre tablas y dependencias entre columnas.
- El vacío por diseño: celdas vacías que son correctas, la señal que pide declararlas y todo lo que se le declara al paquete.
- Limpiar con un plan: qué propone el plan, cómo se aplica sobre una copia y qué deja sin cubrir.
- Del hallazgo a la métrica: de los hallazgos a una propuesta de métricas, que se miden, se agregan y se evalúan contra un umbral.
- Marcos y modelos de calidad: un marco propio, métricas en tres niveles, el tablero, un índice con pesos declarados y los marcos incluidos.
- Comparar entregas y seguir la calidad: comparar entregas, separar un cambio real de un redondeo y buscar deriva en un histórico.
-
Perfilar una base: los dos bloques de
perfilar_dbi(), qué trae a R cada opción y dónde queda el metadato del muestreo. - Colecciones: perfilar las tablas de una base, leer lo que no se pudo medir y buscar relaciones entre ellas.
- Escala y duplicados aproximados: pedir la comparación aproximada, estimar su costo, saber cuándo entra LSH y qué recorta cada tope.
Para usuarios avanzados
La referencia larga está en cuatro artículos del sitio, en castellano. Lo que cambia el costo, la memoria o el significado de un resultado también está en la ayuda de cada función, que viaja con el paquete (?perfilar, ?perfilar_dbi, ?plan_perfilado_dbi, ?detectar_duplicados_aproximados).
| Tema | Dónde |
|---|---|
| Universos y muestreo en SQL, metadatos, motores probados con versión y fecha, costos, lotes, presupuestos de memoria, consistencia entre consultas, dialectos e hilos | Motores y escala |
Qué usa todas las filas y qué se muestrea, no_aplica y no_disponible, unidades y trazabilidad, numeraciones, centinelas, el vocabulario completo de hallazgos y qué se enmascara |
Alcance y cobertura |
| Bancos de evidencia, figuras de rendimiento y cifras de producción, cada una con su fecha y su reproductor | Evidencia y rendimiento |
| Impresión en cualquier locale y reparación de texto mal codificado | Codificación y locales |
| Cada firma, valor por omisión y estructura de retorno | Referencia |
Cada bloque de evidencia dice con qué se reproduce: si se regenera sin red, si requiere un motor o si depende de un recurso descargado, con su fecha y su suma de control (Evidencia y rendimiento).
Cita, licencia y contribuciones
citation("lupa")En una instalación desde CRAN la cita lleva el DOI que CRAN le asigna al paquete, 10.32614/CRAN.package.lupa. Cada versión queda además archivada en Zenodo: 10.5281/zenodo.24117753 resuelve siempre a la última, y cada versión tiene allí su propio DOI para citar una versión exacta.
Las referencias conceptuales son Batini y Scannapieco (2016), el Marco de trabajo para la Gestión de la Calidad de Datos en Gobierno Digital v1.6 de AGESIC, el marco de aseguramiento de la calidad de CEA/CEPAL (2022) e ISO/IEC 25012:2008.
La API pública de lupa puede cambiar antes de la 1.0; los cambios incompatibles se anuncian en NEWS, con una advertencia previa siempre que se pueda. Los contratos estables son las unidades declaradas, el alcance, el registro de auditoría y, cuando se pide, la protección de datos personales; los detalles de implementación y los tiempos pueden cambiar mientras esos contratos sigan siendo ciertos.
Los errores, las propuestas y las correcciones de documentación van al registro de issues, y CONTRIBUTING.md explica cómo contribuir. lupa se distribuye bajo la GPL-3; inst/COPYRIGHTS detalla el material Apache-2.0 traducido de ftfy y los datos MIT tomados de naniar.